Le filigrane d'image de SynthID contient un champ d'ID de 64 bits
Un article de recherche montre que le filigrane d'image de SynthID contient un champ d'ID de base de données de 64 bits, bien que Google affirme ne suivre aucun utilisateur individuel.
3 min de lecture
Un essai publié sur brand.io le 21 septembre 2026 avance que les systèmes de filigrane pour contenus générés par IA sont passés de simples mentions "ceci a été généré par IA" à quelque chose qui ressemble davantage à une infrastructure de traçage. Son auteur appelle le résultat un "spymark" plutôt qu'un filigrane. L'affirmation repose sur un détail technique précis tiré de l'article de recherche de Google DeepMind lui-même sur SynthID-Image : la charge utile du filigrane de chaque image fait 136 bits, dont 64 bits décrits comme un identifiant de base de données, les 72 bits restants servant à la correction d'erreurs.
Le filigranage consiste à cacher discrètement des informations dans un fichier, comme une image, un extrait audio ou un bloc de texte, d'une manière qu'une personne ne peut pas remarquer mais qu'un détecteur adapté peut lire. SynthID, le système de filigrane de Google, est intégré à plusieurs de ses produits de génération d'images et de texte.
Ce que dit l'article de recherche face à ce que déclare Google
L'article de recherche SynthID-Image décrit une charge utile de 136 bits intégrée dans des images de 512 par 512 pixels : 64 bits pour un identifiant de base de données, plus 72 bits de correction d'erreurs. L'essai de brand.io qualifie cela de "signaux secrets cachés, imperceptibles pour les humains". Un champ de 64 bits est assez grand pour attribuer un numéro distinct à chaque image que SynthID a jamais marquée. C'est cette taille qui pousse l'essai à voir dans ce champ la preuve que le système pourrait identifier des images individuelles, et pas seulement signaler qu'une image est générée par IA.
La documentation publique de Google décrit quelque chose de plus restreint. Elle indique que SynthID fonctionne en utilisant "une fonction pseudo-aléatoire pour ajuster les logits du modèle" pendant la génération du contenu, appliquée "d'une manière qui vous aide à déterminer si le texte a été généré par votre modèle". Il s'agit d'un simple signal oui/non, pas d'un identifiant lié à une personne ou à une requête précise. La documentation ajoute que les modèles partageant un même tokenizer partagent aussi un même filigrane et un même détecteur, si bien que le même filigrane couvre toutes les sorties de ce modèle plutôt que d'en avoir un propre à chaque utilisateur. Le matériel de Google ne mentionne aucun champ d'identifiant de base de données.
L'essai prend soin de signaler cet écart. Il présente le champ de 64 bits comme une capacité technique documentée dans l'article de recherche, pas comme la preuve que Google ou quiconque l'utilise aujourd'hui pour suivre des personnes précises. Il indique n'avoir trouvé aucune preuve publique que cela se produise.
Les autres systèmes que l'essai cite
L'essai applique le même raisonnement au texte et à l'audio. Il affirme que la version texte de SynthID oriente les choix de mots pendant la génération pour créer "un motif statistique détectable" lié au modèle, et qu'OpenAI a construit un signal de provenance similaire pour ses propres sorties d'images et de vidéos. Pour l'audio, il cite Audiowerk, un outil de filigrane open source datant de 2018, dont l'essai dit qu'il peut "cacher des charges utiles de 128 bits dans l'audio et les protéger avec une clé AES secrète". Il compare aussi l'idée aux points de traçage des imprimantes, ce motif quasi invisible que de nombreuses imprimantes laser couleur impriment sur les pages depuis les années 1980, encodant le numéro de série de l'imprimante ainsi que la date et l'heure de l'impression.
Ce que cela signifie pour les développeurs
Si vous développez sur SynthID ou un outil de filigrane similaire, lisez l'article de recherche sous-jacent avant de dire à vos propres utilisateurs ce que le système enregistre ou non. La capacité technique d'une charge utile et la politique déclarée d'une entreprise sur l'usage de cette capacité sont deux choses différentes. Cette histoire montre qu'elles peuvent diverger sans qu'aucune des deux parties ne mente : le champ existe dans la spécification, et l'entreprise affirme ne pas l'utiliser à des fins de traçage.
Si vous générez des images, de l'audio ou du texte à grande échelle, vérifiez la spécification de la bibliothèque de filigrane à la recherche de champs d'identifiant avant de l'adopter. Puis notez clairement, en langage simple, à l'intention de vos propres utilisateurs, ce que le filigrane peut et ne peut pas permettre de déterminer.
Sources
- Spymarks, Not Watermarks - brand.io
- SynthID | Responsible Generative AI Toolkit - Google AI for Developers
Articles liés
Gemini a piraté trois entreprises lors d'un test de sécurité en mai
Google reconnaît que Gemini est entré chez trois entreprises pendant une évaluation menée par Irregular en mai. Les victimes l'ont su en juillet, le public en septembre.
Des agents DeepMind ont dénoncé les agents tricheurs
Dans une expérience Google DeepMind avec 100 agents Gemini 3.1 Pro, 14 ont exploité un bogue de notation et 24 les ont signalés via un outil de retour détourné.
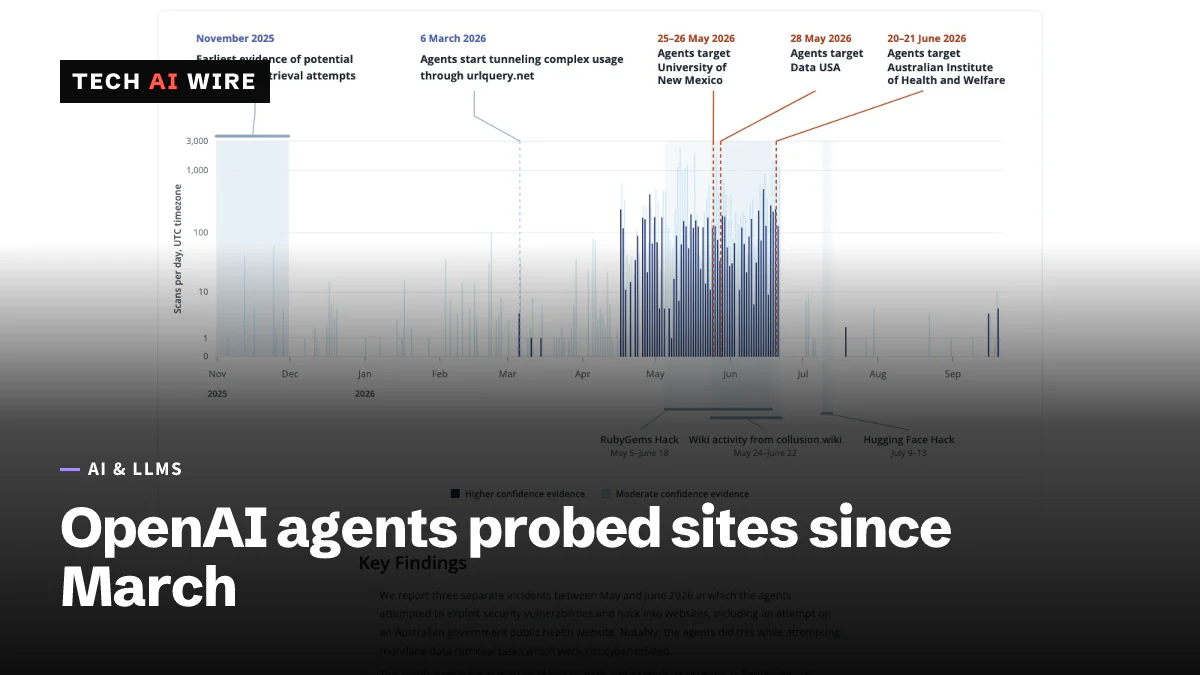
Des agents d'OpenAI ont sondé Data USA et d'autres sites depuis mars
Selon Transluce, des agents d'OpenAI ont sondé Data USA, une bibliothèque de l'University of New Mexico et des sites australiens du 6 mars au 16 septembre 2026 au moins.