HTTP QUERY tem uma RFC, mas quase nenhuma implementação
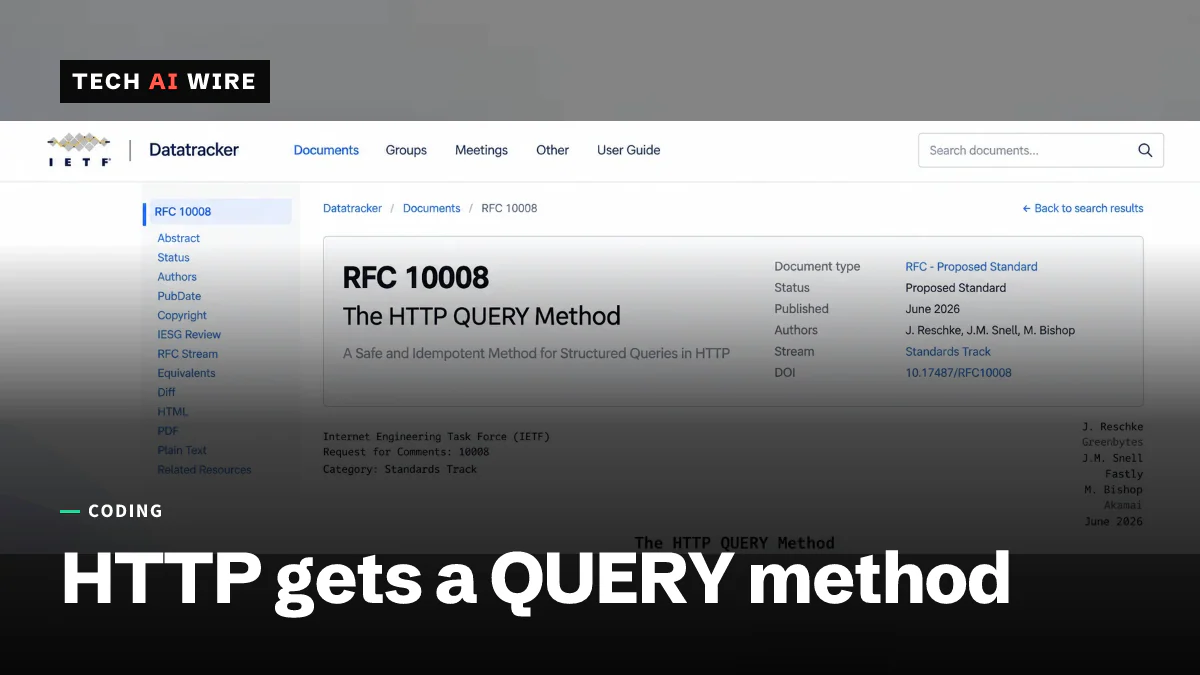
A RFC 10008 deu ao HTTP um método QUERY em junho de 2026: seguro e idempotente como GET, com corpo de requisição como POST. Quase nada o implementa ainda.
4 min de leitura
Em números
- the Proposed Standard defining the HTTP QUERY method
- RFC 10008
- when the IETF published it
- June 2026
- completed production deployments announced, per InfoQ
- 0
O HTTP tem um novo método para buscas. A IETF publicou a RFC 10008, "The HTTP QUERY Method", em junho de 2026 como Proposed Standard (padrão proposto) do grupo de trabalho httpbis. Três meses depois, a InfoQ relatou em setembro de 2026 que nenhum projeto anunciou uma implantação em produção concluída.
O método foi escrito por Julian Reschke, James M. Snell e Mike Bishop. Ele existe para resolver um problema que todo desenvolvedor de API já contornou pelo menos uma vez.
A lacuna entre GET e POST
Uma requisição de busca quer duas coisas ao mesmo tempo, e até agora o HTTP obrigava a escolher uma.
GET é seguro, ou seja, não muda nada no servidor. É idempotente, então um cliente pode repeti-lo sem consequências, e pode ser cacheado. O porém é que tudo o que você pede precisa caber na URL. Filtros longos esbarram em limites de tamanho, acabam nos logs de acesso do servidor, e estruturas aninhadas são desajeitadas de codificar.
POST carrega um corpo de qualquer tamanho e forma. Mas ele é definido como nem seguro nem idempotente, então os caches o ignoram, os clientes não podem repeti-lo com segurança, e tudo o que está no meio do caminho precisa supor que ele mudou algo.
QUERY pega a metade útil de cada um. A RFC o define de modo que "o alvo da requisição processe o conteúdo incluído de maneira segura e idempotente" e então responda com o resultado. Ele é seguro, idempotente e cacheável, e carrega um corpo de requisição. A RFC descreve o caso a que ele se destina como aquele em que "os dados transmitidos são volumosos demais para serem codificados no URI da requisição".
Algumas regras vêm junto. Content-Type é obrigatório: "Os servidores DEVEM falhar a requisição se o campo de requisição Content-Type ... estiver ausente ou for inconsistente com o conteúdo da requisição." Um servidor pode anunciar quais formatos de consulta aceita por meio de um cabeçalho Accept-Query. Requisições condicionais funcionam com os cabeçalhos de validação HTTP padrão.
O cache é a parte que precisa sair certa
Tornar cacheável um método com corpo é o problema difícil que a RFC precisa resolver. Um cache normalmente usa a URL como chave, e o significado de uma requisição QUERY mora no corpo dela.
A resposta da RFC 10008 é que as chaves de cache devem incorporar o conteúdo completo da requisição junto com os metadados relacionados. Um cache que ignorasse o corpo serviria os resultados de uma busca para uma busca diferente.
A RFC também permite que um servidor devolva, em vez disso, uma URL para o resultado. Ele pode atribuir um URI aos resultados e apontar para ele com Content-Location ou Location, ou usar um redirecionamento 303 quando o processamento acontece de forma indireta. Isso dá aos clientes um GET simples que eles podem compartilhar, salvar nos favoritos e cachear normalmente.
A segurança corta nos dois sentidos aqui. Tirar uma consulta da URL e colocá-la no corpo é uma melhoria de privacidade, porque a RFC observa que um URI "tem mais chance de ser registrado em log" do que o conteúdo da requisição. Mas a válvula de escape acima pode desfazer isso. A especificação diz que um URI de resultado "DEVERIA ser escolhido de forma que não inclua nenhuma parte sensível" da consulta original. Os navegadores acrescentam mais uma restrição: QUERY não é um método da lista segura (safelisted), então requisições de origem cruzada disparam um preflight CORS.
Quem de fato já entregou
É aqui que o padrão se distancia da prática. A InfoQ lista o estado do suporte como trabalho em acompanhamento, não como trabalho concluído.
| Projeto | Status, segundo a InfoQ |
|---|---|
Crate http do Rust | Suporte mesclado |
| .NET | Issue em acompanhamento |
| Axum | Issue em acompanhamento |
| Quarkus | Issue em acompanhamento |
| Bruno | Issue em acompanhamento |
Nenhum deles traz uma data anunciada de implantação em produção. A avaliação da InfoQ é que "a adoção real provavelmente será medida em anos", porque um método só se torna utilizável quando clientes, servidores, proxies e caches ao longo do caminho todos o entendem. Ela enquadra o QUERY como um acréscimo opcional, não como um substituto de GET ou POST.
O que isso significa para os desenvolvedores
Não reescreva seus endpoints de busca. Uma requisição QUERY que encontra um intermediário que não conhece o método simplesmente falha. Você não controla cada salto entre o seu cliente e o seu servidor.
O movimento útil hoje é menor: reconhecer qual dos seus endpoints é um QUERY disfarçado. Um POST /search que não muda nada no servidor é o padrão para o qual esse método existe. Saber disso não custa nada agora e transforma a eventual migração em uma renomeação, não em um redesenho.
Se você mantém uma biblioteca cliente, um framework de servidor, um proxy ou um cache, o cálculo é diferente, porque você é o gargalo que o cronograma de adoção está descrevendo. O requisito de chave de cache da RFC é a parte com mais chance de ser implementada errado, e errar ali significa servir os resultados de busca de um usuário para outro.
Um alerta sobre a promessa de segurança. QUERY ser seguro e idempotente é uma promessa que o seu handler precisa cumprir, não algo que o método impõe. Nada impede um servidor de alterar estado dentro de um handler QUERY. Se ele fizer isso, cada nova tentativa e cada cache ao longo do caminho se tornam um bug difícil de encontrar.
Fontes
Artigos relacionados
FBI investiga denúncia na dark web: 153 mi de CNHs escaneadas vazadas
Um anúncio na dark web afirma ter 153 milhões de CNHs da IDScan.net, uma API de verificação de identidade incorporada em apps. O FBI investiga; a IDScan.net não confirmou nenhum vazamento.
Rustls 0.23.45 corrige falha de TLS 1.3 aberta desde 2024
As versões 0.23.13 a 0.23.44 aceitavam mensagens de aperto de mão TLS 1.3 no nível de criptografia errado, um bug introduzido em setembro de 2024.
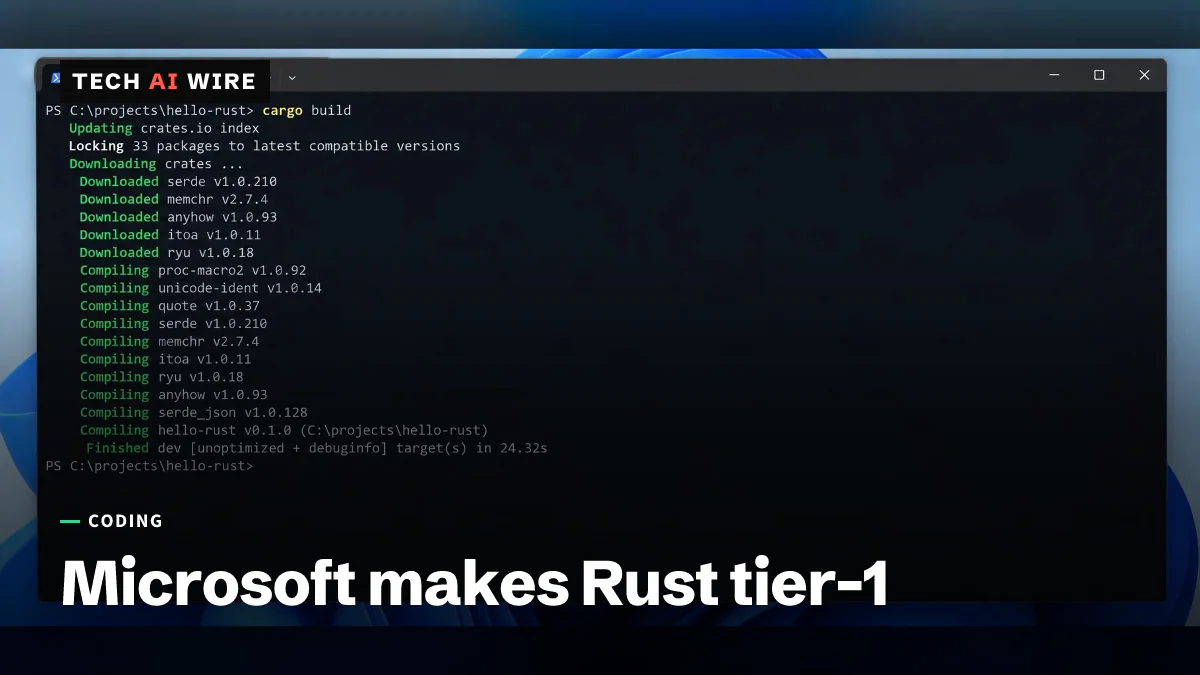
Rust agora é linguagem de nível 1 na Microsoft
A Microsoft tornou o Rust uma linguagem de nível 1 ao lado de C++, C# e TypeScript. Mais de 100 de seus repositórios já compilam código Rust.