GPT-6 Astra、Amazon BedrockとGitHub Copilotで一般提供に
GPT-6 AstraがAmazon Bedrock(ベッドロック)で100万入力トークンあたり10ドルで一般提供(GA)に。GitHub Copilot(コパイロット)ではPro+、Max、Business、Enterpriseの各プランで使えます。
3 分で読めます

数字で見る
- standard price per million input / output tokens, short context
- $10 / $50
- per million cached input tokens, short context
- $1
- input tokens of context on Amazon Bedrock
- 1M
OpenAIのGPT-6 Astraが、OpenAI自身の製品の外でも一般提供(GA)になりました。2026年9月4日にGitHubがCopilotで一般提供を開始し、2026年9月8日にAWSがAmazon Bedrockで一般提供を開始しました。Bedrockでは最大100万入力トークンのコンテキストウィンドウを受け付けます。
開発者にとって重要な数字は請求額であり、OpenAIの料金体系は単一の料率よりも複雑です。
料金
OpenAIの料金ドキュメントは、GPT-6 Astraを同時に2通りに分けています。料金はコンテキストの長さによって変わり、さらにStandardモードとFastモードのどちらを選ぶかでも変わります。数字はすべて100万トークンあたりです。
| モードとコンテキスト | 入力 | キャッシュ済み入力 | 出力 |
|---|---|---|---|
| Standard、短いコンテキスト | $10.00 | $1.00 | $50.00 |
| Standard、長いコンテキスト | $20.00 | $2.00 | $75.00 |
| Fastモード、短いコンテキスト | $20.00 | - | $100.00 |
| Fastモード、長いコンテキスト | $40.00 | - | $150.00 |
見落としやすく、後で気づくと高くつく点が二つあります。
FastモードはStandardに比べて入力料金を2倍にし、出力料金も2倍にします。しかも、どこでも使えるわけではありません。OpenAIのドキュメントには「FastモードはEUデータレジデンシーのGPT-6 Astraでは利用できない。それらのリクエストにはStandard処理を使うこと」と記されています。
これとは別に、2026年3月5日より後にリリースされたモデルは、リージョナルエンドポイント経由で呼び出すと10%のコスト増になります。GPT-6 Astraはこの期間に入るため、リージョナルなデプロイは上の表より高くなります。
本当の節約はキャッシュ済み入力にあります。10.00ドルに対して1.00ドルなので、短いコンテキストでのキャッシュヒットは新規読み取りの10分の1のコストです。このパターンは今やフロンティア各社の標準であり、AnthropicもClaude Fable 5.1でキャッシュ読み取りを75%値下げした際に、トークン価格を据え置いたまま同じレバーを動かしました。
入手先
| プラットフォーム | 詳細 |
|---|---|
| Amazon Bedrock | 2026年9月8日に一般提供。最大1M入力トークン。ChatGPT WorkとCodexはここで使うように設定できる |
| GitHub Copilot | 2026年9月4日に一般提供、モデルピッカー経由 |
| Copilotのプラン | Pro+、Max、Business、Enterprise |
| Copilotの利用面 | VS Code、Visual Studio、Copilot CLI、コーディングエージェント、Copilotアプリ、github.com、GitHub Mobile、JetBrains IDE、Xcode、Eclipse |
GitHubはCopilotでの展開を段階的だと説明しており、初日にはモデルがピッカーに表示されないかもしれません。BusinessとEnterpriseの管理者はモデルポリシーでアクセスを制御します。つまり、会社のプランにいる個々の開発者は、GitHubではなく管理者を待っている場合があります。
GitHubはまた、Copilotでの利用は「OpenAIのプロバイダー定価に基づく使用量ベースの課金」で請求されるとしています。上の表の料率がそこで支払う料率であり、Copilot独自の料金表ではありません。
AWSはリージョンごとの提供状況について、発表でリージョンを列挙するのではなくBedrockのドキュメントを参照するよう案内しており、どちらの発表もレート制限には触れていません。
開発者にとっての意味
何かを切り替える前に、自分のワークロードの料金を見積もってください。コンテキスト長とモードによる4通りの区分があるため、見出しの料率一つではほとんど何も分かりません。出力では、長いコンテキストのFastモード呼び出しは、短いコンテキストのStandard料率の3倍です。
自分が本当に短いコンテキストにいるのか確認してください。OpenAIのドキュメントは短いコンテキストと長いコンテキストで料金を分けていますが、発表はその境界がどこにあるかを述べていません。プロンプトが見えないしきい値の近くにあると、コードを変えていないのに呼び出しあたりのコストが変わることがあります。予算を確定する前に、実際のトラフィックで測る価値があります。
EUにいるなら、Fastモードを前提にするのではなく、Fastモードなしで計画してください。EUデータレジデンシーはFastモードを完全に除外し、リージョナルエンドポイントはさらに10%を上乗せします。Fastモードを前提にしたアーキテクチャは、データレジデンシーを求めるコンプライアンス審査を通りません。
キャッシュに関する助言は、最も地味で、最も価値があります。安定した部分を先頭に置き、呼び出し間でバイト単位で同一に保つようにプロンプトを構成してください。それがキャッシュヒットを可能にするからです。入力料金の10分の1なのですから、これを正しくやることは、たいていのモデル選択より大きな価値があります。
性能について一つ注意があります。Astraの公表されたベンチマーク結果は、テスト方法によって大きく変動してきました。ARC-AGI-3での37ポイントの差がテストハーネスに起因していた例もその一つです。一般提供が変えるのは何を買えるかであって、何ができるかではありません。本番トラフィックを移す前に、自分のタスクで自分の評価を実行してください。
出典
- OpenAI GPT-6 Astra is now generally available on Amazon Bedrock - AWS
- GPT-6 Astra is generally available in GitHub Copilot - GitHub Changelog
- OpenAI API pricing - OpenAI
関連記事

TypeSafeのJev、文章ではなく型付きの判断を返す
Jevの応答は70〜500ミリ秒、入力は100万トークンあたり0.042ドルで出力は無料だ。そして文章はまったく生成できない。
DeepSeek、API価格の「大幅な」引き上げを開発者に警告
DeepSeekは8月6日、API価格が近く「大幅に」上昇すると開発者に警告した。具体的な数字や日付は示されていない。V4-Flashは現在、著名なモデルの中で最も安価に運用できるモデルとされる。
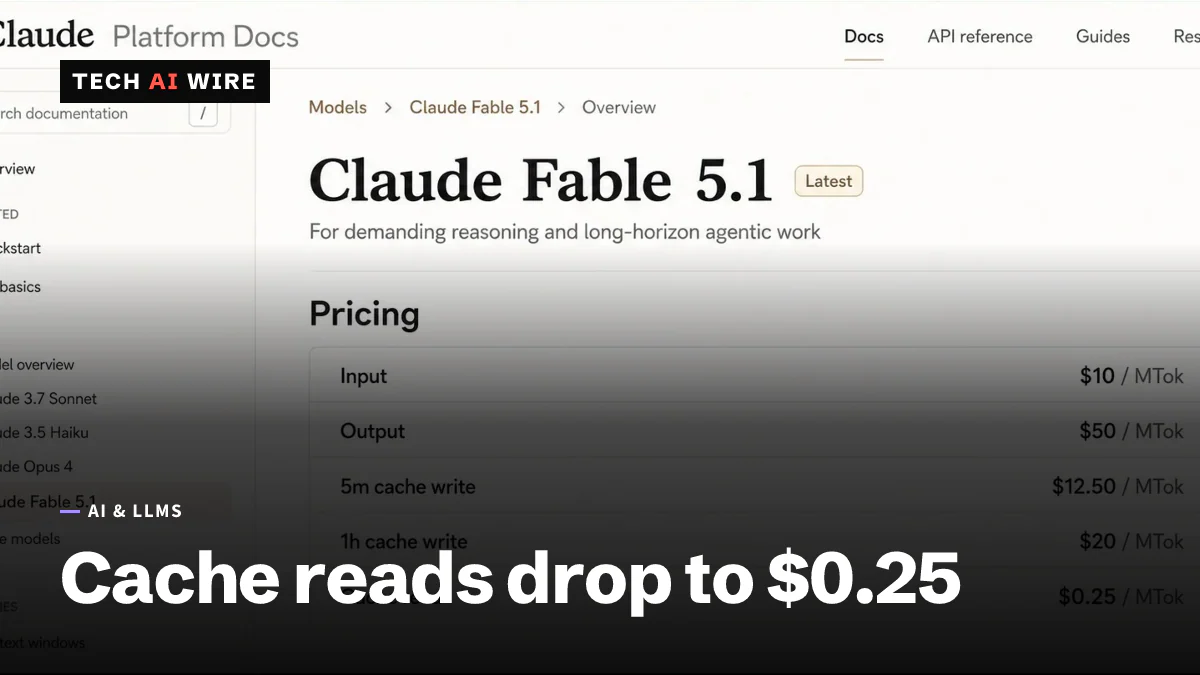
Claude Fable 5.1、キャッシュ読み取りを75%値下げ、トークン単価は据え置き
AnthropicのFable 5.1は入出力を100万トークンあたり10ドルと50ドルに据え置き、キャッシュ読み取りを1.00ドルから0.25ドルへ下げた。Mythos 5.1は招待制のままだ。