Gemini 4 Argon、開発者より先にサイバー防御チームへ提供
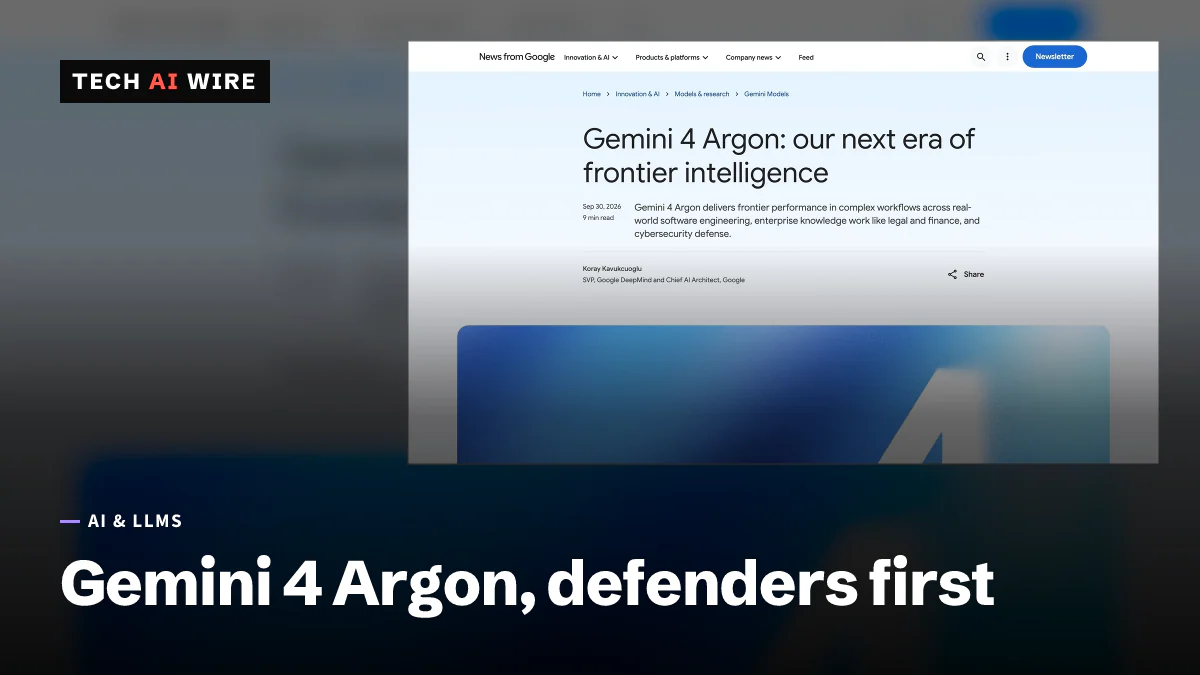
Gemini 4 Argon(ジェミニ4アルゴン)はDeepSWE v1.1で77.9%を記録し、1回の回答で100万トークンを書けます。ただし現時点で使えるのは、GoogleのFairwind Programに参加するサイバー防御者だけです。
4 分で読めます
数字で見る
- output tokens per answer, up from 64K
- 1M
- per million input / output tokens, introductory
- $2 / $10
- discount on cached input tokens
- 95%
- on CWE-bench v1, tied for first
- 68%
- Gemini 4 Argon
- 77.9%
- Claude Opus 5.5
- 74.2%
- GPT-6 Astra
- 74.1%
Googleは2026年9月30日、Gemini 4 Argonをリリースし、同社で最も強力なモデルだとしています。ほとんどの開発者は、まだ使えません。Googleはまず、Fairwindというプログラムを通じて、信頼できるセキュリティチームに提供します。有料のAPI顧客はその後です。
この順番は、モデルについて多くを物語っています。GoogleはArgonを、ソフトウェアのセキュリティホールを自力で見つけて修正するために作りました。防御側のためにそれができるモデルは、攻撃者の助けにもなり得ます。そのためGoogleは、幅広い公開を控えています。
Googleが説明するArgonの能力
Argonは、コーディング、調査、執筆、サイバーセキュリティといった、長く複数の手順を要する作業を対象としています。Googleの発表によると、Argonは1回の回答で最大100万トークンを書けるようになりました。これまでは6万4,000トークンでした。トークンとは文章の小さなかたまりで、多くは短い単語か、長い単語の一部です。出力の余裕が増えれば、1回のリクエストで、書き直したファイル全体を、あるいは複数のファイルを生成できます。
TechCrunchによると、Googleは、Argonが「重大なソフトウェア脆弱性を自律的に発見し、検証し、パッチを当てる」ように作られているとしています。動画やグラフも分析できます。TechCrunchによれば、Googleの社員はすでに、デバッグや、大規模なコードベースを新しいライブラリーへ移行する作業に使っています。
Googleは次のスコアを公表しました。
| ベンチマーク | 測るもの | Argonのスコア |
|---|---|---|
| DeepSWE v1.1 | 実際のソフトウェアエンジニアリング作業 | 77.9% |
| AutomationBench | 自動化タスク(GoogleによればArgonが1位) | 51.3% |
| CWE-bench v1 | 既知の種類のセキュリティ上の欠陥の修正 | 68%(1位タイ) |
| LVBench | 長い動画の理解 | 91.7% |
9to5Googleは、DeepSWEの結果を2つの競合モデルと比べています。AnthropicのClaude Opus 5.5は74.2%、OpenAIのGPT-6 Astraは74.1%です。TechCrunchはさらに、Vals AIのモデル指標でも、ArgonがGPT-6 Astraや、AnthropicのFableとOpusの各モデルを上回ったと伝えています。
誰が、いつ使えるのか
現時点で利用できるのは、Fairwind Programだけです。その参加者は、Googleがシステムの防御を任せられると信頼するセキュリティチームです。Googleによると、次に有料のAPI顧客とGoogle AI Ultraの契約者が使えるようになり、その後さらに広く公開されます。
「このレベルの最先端の能力を安全に公開するには、段階的なアプローチが必要です」と、Google DeepMindのシニアバイスプレジデント、Koray Kavukcuoglu氏は述べました。Googleには慎重になる理由があります。9月、Googleは5月のセキュリティテストでGeminiが3社に侵入していたことを公表しました。
Googleは、Argonの安全対策をいくつか挙げています。間接プロンプトインジェクションに対するテストを行いました。これは、攻撃者が、モデルの読むウェブページやファイルの中に指示を隠す手口です。レッドチームも使いました。レッドチームとは、システムを攻撃することが仕事のテスト担当者です。9to5Googleによると、Googleは悪用の兆候がないかモデルの内部の動きを監視し、モデルがコードを実行するサンドボックスを強化しています。
料金
Argonの導入価格は、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルです。導入期間が終わると、価格は2倍の4ドルと20ドルになります。キャッシュされた入力トークンは、通常の入力より95%安くなります。キャッシュとは、長い文書のように何度も送る文章のかたまりを、サービス側が保存しておく仕組みです。これにより、毎回正規の料金を払わずに済みます。
Googleのコーディング向けモデルは、Argonだけではありません。9月上旬にはGemini 3.8 Flashをリリースしました。日常的なコーディング作業向けの、中位モデルという価格設定です。
Googleが説明する、社内でのArgonの活用
Googleは、自社のシステムでの例を3つ挙げています。Argonで動くエージェントが、Googleのデータセンター全体で300TiBを超えるメモリーを解放しました。Googleは、節約の総量を500TiBから1PiBと見積もっています。Argonはまた、GoogleのAV1動画デコーダーであるlibgav1を、2.7倍速く動く新しいコードへ移行するのにも役立ちました。9to5Googleによると、80万行を超えるコードの移行が行われました。
これが開発者にとって意味すること
まだArgonを前提にリリースを計画しないでください。チームがFairwindに入っていない限り、今日は呼び出せません。今使っているモデルで、出荷を続けましょう。
待つ間に、テストセットを用意しましょう。Googleのスコアは、Google自身が出したものです。DeepSWEでの3.7ポイントの差は本物ですが、小さな差です。また、自分たちのコードがベンチマークと合うとは限りません。バックログから、正解が分かっている実際のタスクを20〜50件集めてください。そうすれば、初日からArgonを公平に比べられます。
100万トークンの出力上限について考えましょう。モジュールの書き直しや、完全な移行処理の作成など、大きな作業を1回のリクエストで行えます。一方で、高額な請求にもつながります。100万トークンをすべて使った回答1件は、導入価格で10ドル、その後は20ドルかかります。テストの前に、コードで出力の上限を設定してください。
キャッシュを前提にプロンプトを設計しましょう。キャッシュされた入力は95%割引になるので、リポジトリーのコンテキストやAPIドキュメントのような、大きく変わらない部分を先頭に置きます。変わる質問は最後に置きます。このパターンにより、長時間のエージェント実行で、入力コストを大きく下げられます。
セキュリティの仕事をしているなら、Fairwindに注目しましょう。GoogleはArgonを脆弱性の発見と修正のために作り、防御側が最初に使えます。コードスキャンやパッチの取り組みを運用するチームは、Googleがどのようにアクセスを広げるかを追いかけるべきです。
出典
関連記事
Chrome、メジャー更新を2週間ごとに
Chrome 153から、メジャーマイルストーンの間隔が4週間から2週間になります。Chrome 149と150だけで1,072件のセキュリティバグを修正しました。大規模言語モデル(LLM)が脆弱性を大量に見つけています。

Xiaomi、1兆パラメーターのMiMo-V2.6-ProをMITライセンスのオープンウェイトで公開
Xiaomi(シャオミ)のMiMo-V2.6-Proは、パラメーター数が1.02兆、うちアクティブなものが420億で、100万トークンのコンテキストを持ち、重みはMITライセンスです。ただし、約680GBのGPUメモリーが必要です。
OpenAI、推論抽出キャンペーンをMoonshot AIに関連付け
OpenAIによると、Kimiを開発するMoonshot AI(ムーンショットAI)に関係するユーザーが7月、4,000人を超えるユーザーから16,000件の抽出リクエストを送り、OpenAIのモデルの隠された推論をコピーしようとしました。