Microsoft ThinkingBox note les agents d'IA d'après la base de données
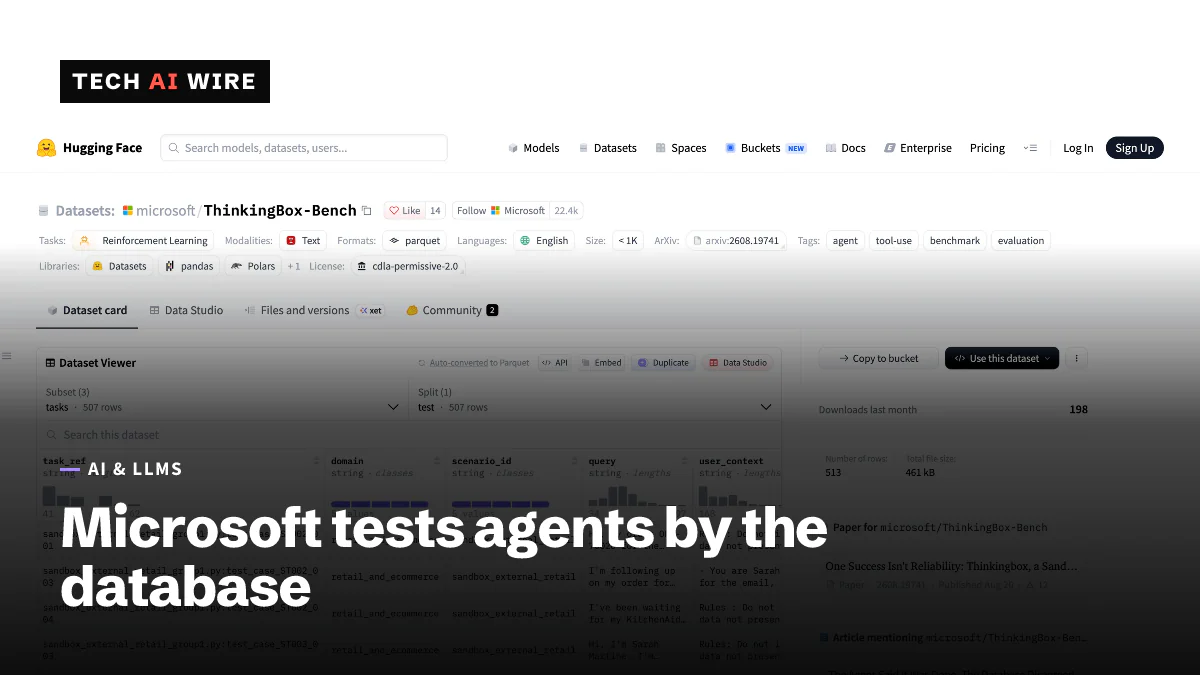
ThinkingBox, de Microsoft, vérifie ce qu'un agent d'IA a écrit dans la base de données. 67,24 % des 79 853 exécutions échouées se sont terminées proprement, avec des appels d'outils valides et des données fausses.
3 min de lecture
En chiffres
- tasks across five business domains
- 507
- runs of every task, to separate luck from reliability
- 20
- of failed runs ended cleanly with valid tool calls
- 67.24%
- of failures came from tool handling, not reasoning
- 79.9%
- Claude Opus 5.5
- 67.16%
- Claude Opus 5
- 66.5%
- GPT-5.4
- 65.36%
- GPT-6 Astra
- 58.31%
- Kimi-K3
- 57.37%
Microsoft a publié ThinkingBox, un test pour agents d'IA qui ignore ce que dit l'agent et vérifie ce qu'il a réellement modifié. Microsoft l'a annoncé le 3 octobre 2026 dans un billet de blog sur Hugging Face. Sa conclusion principale devrait inquiéter tous ceux qui déploient des agents. Sur 79 853 tentatives échouées, 67,24 % se sont terminées proprement, avec des appels d'outils valides et sans erreur. Les données sous-jacentes étaient pourtant fausses.
Comment ThinkingBox teste un agent
Un agent d'IA est un modèle qui agit au moyen d'outils, par exemple pour mettre à jour une commande ou modifier une réservation. La plupart des tests jugent la réponse finale de l'agent ou vérifient que ses appels d'outils étaient bien formés. ThinkingBox examine plutôt la base de données du back-end, une fois la tâche terminée.
RuntimeWire le décrit comme un benchmark où la base de données a le dernier mot. Chacune de ses 507 tâches simule un vrai processus métier. Chaque tâche est exécutée 20 fois, pour qu'un succès isolé dû à la chance ne compte pas comme fiable.
Les tâches couvrent cinq domaines, selon le billet de Microsoft :
| Domaine | Tâches |
|---|---|
| Commerce de détail | 98 |
| Assurance automobile | 100 |
| Conseil (support informatique et RH) | 101 |
| Voyage | 104 |
| Support de néobanque | 104 |
Les trois scores
ThinkingBox publie trois chiffres par modèle, explique RuntimeWire. Pass@1 est la probabilité de réussir en une seule tentative. Pass@20 signifie que la tâche a réussi au moins une fois sur 20 exécutions. « Observed 20/20 » compte les tâches que le modèle a réussies à chaque fois, sans exception.
L'écart entre ces chiffres est le vrai sujet. Claude Opus 5.5 arrive en tête en pass@1 avec 67,16 %, mais n'a réussi les 20 exécutions que sur 47,53 % des tâches, soit 241. Kimi-K3 obtient 57,37 % en pass@1 et n'a réussi les 20 exécutions que sur 13,41 %, soit 68 tâches.
Selon le billet de Microsoft, seuls trois modèles ont conservé plus de 70 % de leur score pass@1 sur les 20 essais.
Pourquoi les agents échouent en silence
Microsoft a constaté qu'environ quatre échecs sur cinq, soit 79,9 %, venaient de la gestion des outils plutôt que du raisonnement. Le modèle avait compris la tâche, mais il a appelé un outil de la mauvaise façon, sur le mauvais enregistrement, ou seulement en partie.
C'est ainsi qu'une exécution peut sembler parfaite tout en étant fausse. « Le message final d'un agent est un indice de ce qu'il croit s'être produit, pas la preuve de ce que le logiciel a réellement enregistré », écrit Remio. Le site avertit que de fausses confirmations sur des commandes, des abonnements ou des autorisations causent des problèmes plus tard, quand d'autres systèmes s'appuient dessus.
Bon marché par tentative ne veut pas dire bon marché par tâche
Microsoft a aussi chiffré la fiabilité. GPT-5.6 Sol coûte 0,127 $ par tentative réussie. Compté par tâche qu'il accomplit de façon fiable, le coût monte à 9,76 $. Un modèle bon marché par appel peut coûter cher une fois que vous payez les nouvelles tentatives et les échecs.
Ce que cela signifie pour les développeurs
Testez votre agent comme le fait ThinkingBox. Après chaque exécution de test, interrogez la base de données et vérifiez par assertion les champs exacts qui auraient dû changer. Vérifiez aussi que rien d'autre n'a changé. Une réponse correcte et des journaux d'outils propres ne prouvent pas grand-chose à eux seuls.
Exécutez chaque cas de test de nombreuses fois, pas une seule. Une tâche qui réussit une fois peut encore échouer souvent en production, comme le montrent les chiffres de Kimi-K3. Suivez la part des tâches qui réussissent à chaque exécution, pas seulement la moyenne.
Concentrez vos efforts sur la couche d'outils. Si la plupart des échecs viennent de la gestion des outils, les correctifs relèvent souvent de l'ingénierie ordinaire. Rédigez des descriptions d'outils plus claires, utilisez des schémas d'arguments plus stricts et renvoyez des messages d'erreur que le modèle peut exploiter.
Ajoutez une vérification en dehors du modèle en production. Avant d'annoncer à un utilisateur qu'une commande a changé, relisez-la depuis le système de référence. Le constat de Remio tient : le rapport de l'agent lui-même est une affirmation, pas une preuve.
Budgétez par tâche fiable, pas par token. Les chiffres de Microsoft sur GPT-5.6 Sol montrent que le prix par appel peut largement sous-estimer le coût réel.
Sources
Articles liés
Holo4 : des modèles d'agents à poids ouverts obtiennent 61,7 % sur OSWorld 2.0
Holo4-27B de H Company obtient 61,7 % sur OSWorld 2.0 pour 1,22 dollar par tâche, mais seul son modèle frère sous Apache 2.0, 35B-A3B, peut être auto-hébergé à des fins commerciales.

NVIDIA Kumo Tabular prend la tête de TabArena avec des poids ouverts
Kumo Tabular de NVIDIA prédit à partir d'un tableau étiqueté en une seule passe, sans aucun entraînement. Il se classe premier sur TabArena avec 1 950 Elo, dans des tailles de 28M à 215M.

Liquid AI LFM2.5-VL-DSpark accélère son modèle de vision 3B
Le modèle brouillon LFM2.5-VL-DSpark de Liquid AI, avec 280M de paramètres, décode son modèle de vision 3B jusqu'à 3.13x plus vite sur un M5 Max, avec une sortie identique.