Google et Meta ont lancé cette semaine des modèles pour le code
Gemini 3.8 Flash de Google et Muse Spark 1.3 de Meta sont sortis à un jour d'écart, tous deux ciblant le code et les tâches d'agents, et tous deux positionnés en milieu de gamme tarifaire.
2 min de lecture
En chiffres
- Gemini 3.8 Flash's per-million-token input/output price through 2026
- $0.75 / $3.75
- Muse Spark 1.3's per-million-token input/output price
- $1.25 / $4.25
- token context window both new models share
- 1M
Google a lancé Gemini 3.8 Flash le 2 septembre, et Meta a suivi moins d'un jour plus tard avec Muse Spark 1.3. Les deux visent la même niche : des modèles de milieu de gamme tarifés pour du code et des tâches d'agents à fort volume, pas seulement pour les meilleurs scores de benchmarks.
Gemini 3.8 Flash : bon marché, pensé pour de longues sessions de code
Gemini 3.8 Flash coûte 0,75 $ par million de tokens en entrée et 3,75 $ par million en sortie jusqu'à fin 2026, selon l'annonce de Google. Google affirme qu'il surpasse la plupart des modèles de pointe plus volumineux sur DeepSWE v1.1, un benchmark qui mesure la résolution autonome et complète de problèmes d'ingénierie logicielle longs et complexes.
Sur Terminal-Bench 2.1, un test d'exécution réelle de tâches en ligne de commande, DataCamp rapporte que Gemini 3.8 Flash obtient 90,8 %, contre 81,6 % pour 3.7 Flash. Le raisonnement général, mesuré par Humanity's Last Exam, a à peine bougé : 45,4 % contre 45,7 % pour la version précédente. Google concentre ses efforts d'amélioration sur le code et les capacités d'agent, pas sur la connaissance brute.
Google a aussi lancé une variante Cyber restreinte via son programme Fairwind, limitée à des défenseurs vérifiés. Google indique un taux de réussite dépassant 70 % sur un benchmark interne de découverte de vulnérabilités, et un score de 47,2 % sur CWE-Bench, un benchmark public pour corriger automatiquement des failles de sécurité connues.
Muse Spark 1.3 : un grand bond, mais pas un modèle ouvert
Muse Spark 1.3 obtient 61 points sur l'Intelligence Index d'Artificial Analysis, selon Trending Topics. C'est juste derrière Claude Opus 5 et GPT-5.6 Sol, et devant les 59 points que le média attribue à Gemini 3.8 Flash sur la même échelle. Les progrès rapportés par Meta elle-même sont nets : la précision sur les tâches bancaires est passée de 35 % à 47 %, et celle des opérations en terminal de 80 % à 85 %.
Malgré la façon dont certains médias en parlent, Muse Spark 1.3 n'est pas un modèle à poids ouverts. LLM Stats le décrit comme "un modèle de raisonnement multimodal propriétaire", disponible uniquement via l'API propre de Meta. Trending Topics note que Meta s'était engagée à publier les poids du précédent Muse Spark 1.2, mais n'a pas encore décidé si ceux de 1.3 suivront. Les prix s'établissent à 1,25 $ par million de tokens en entrée et 4,25 $ par million en sortie.
Ce que cela signifie pour les développeurs
Si vous choisissez un modèle pour un agent qui écrit et exécute du code, comparez ces deux-là entre eux sur votre propre charge de travail. Ne vous contentez pas de les comparer aux modèles phares dont tout le monde parle ; les deux sont construits et tarifés précisément pour cette tâche.
Ne supposez pas que vous pourrez auto-héberger Muse Spark 1.3. Contrairement aux précédentes versions de Muse chez Meta, celle-ci est pour l'instant uniquement disponible via API. Toute dépendance à ce modèle est une dépendance à l'infrastructure et à la tarification de Meta, pas aux vôtres.
Observez la tendance derrière ces scores, pas seulement les scores eux-mêmes. Deux grands laboratoires qui lancent à un jour d'écart des modèles de milieu de gamme optimisés pour le code, à des prix similaires, montre où s'est déplacée la vraie compétition : pas au sommet du classement, mais sur le segment que les développeurs utilisent réellement au quotidien, en grand volume.
Sources
Articles liés
Meta lance Muse Wonder, son premier modèle frontière
Meta a lancé Muse Wonder le 12 octobre à 4 dollars par million de tokens en entrée et 20 dollars par million en sortie. Le modèle plus grand, Wonder Full, est réservé à Muse Code.
Les modèles GPT-6 d'OpenAI arrivent sur Google Cloud en préversion
Google Cloud a lancé le 21 octobre 2026 une préversion privée des modèles GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna d'OpenAI, facturés via sa Marketplace.
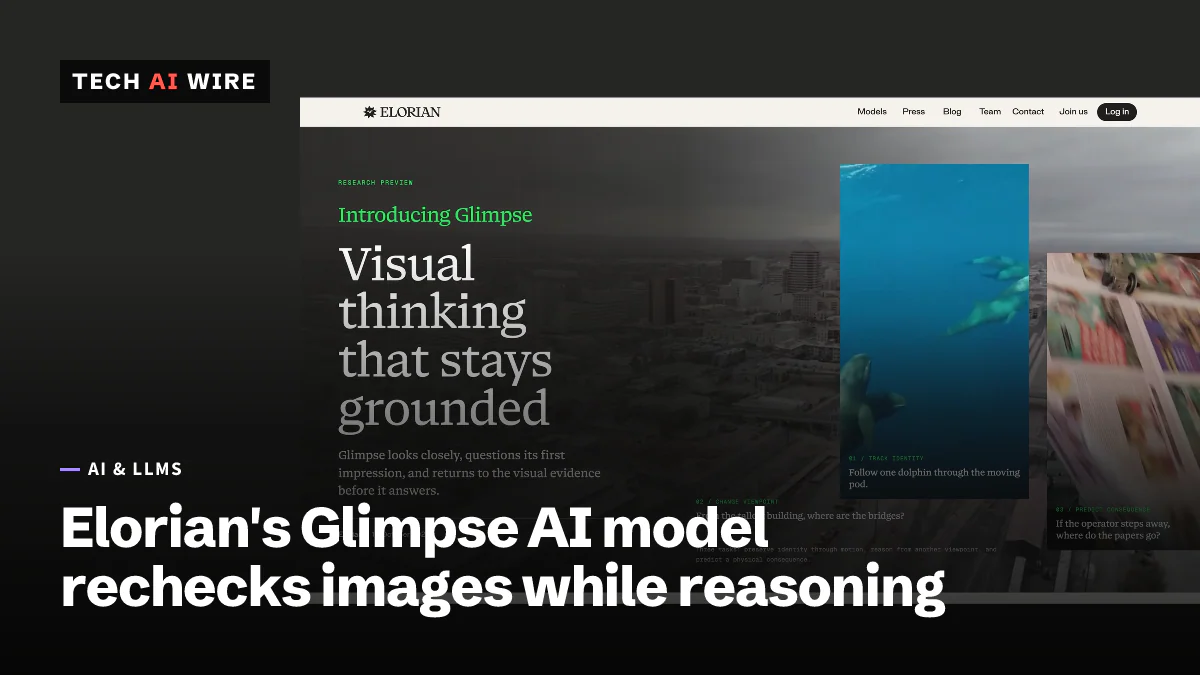
Le modèle Glimpse d'Elorian réexamine les images pendant qu'il raisonne
Glimpse, le premier modèle d'Elorian, coûte 0,60 $ par million de tokens en entrée et revient sur les images pendant qu'il raisonne. Il a battu GPT-6 Astra sur 4 tests sur 11.